
Read time :
Qu’est-ce qu’un GTM context layer ? Les données dont l’IA a besoin pour répondre à une question marketing
Connectez Claude à Salesforce et le marketing gagne un analyste. C’est la promesse de Claudeforce, en bêta ouverte depuis ce mois-ci. Avec Sam Altman sur scène au Dreamforce cette semaine, nous sommes à peu près sûrs que Chatforce deviendra bientôt une réalité, lui aussi.

Les deux poursuivent la même promesse : devenir votre collègue IA connecté à votre CRM. L’idée est de pouvoir poser n’importe quelle question sur le pipeline et le revenu, et d’obtenir une réponse sans construire le rapport vous-même.
En réalité, vous obtiendrez un analyste capable d’examiner toutes vos fiches CRM, mais muet sur la manière dont le marketing a influencé chacune d’elles, qu’il s’agisse d’un Contact ou d’une Opportunity.
Cette information manquante, c’est le GTM context layer (la couche de contexte GTM).
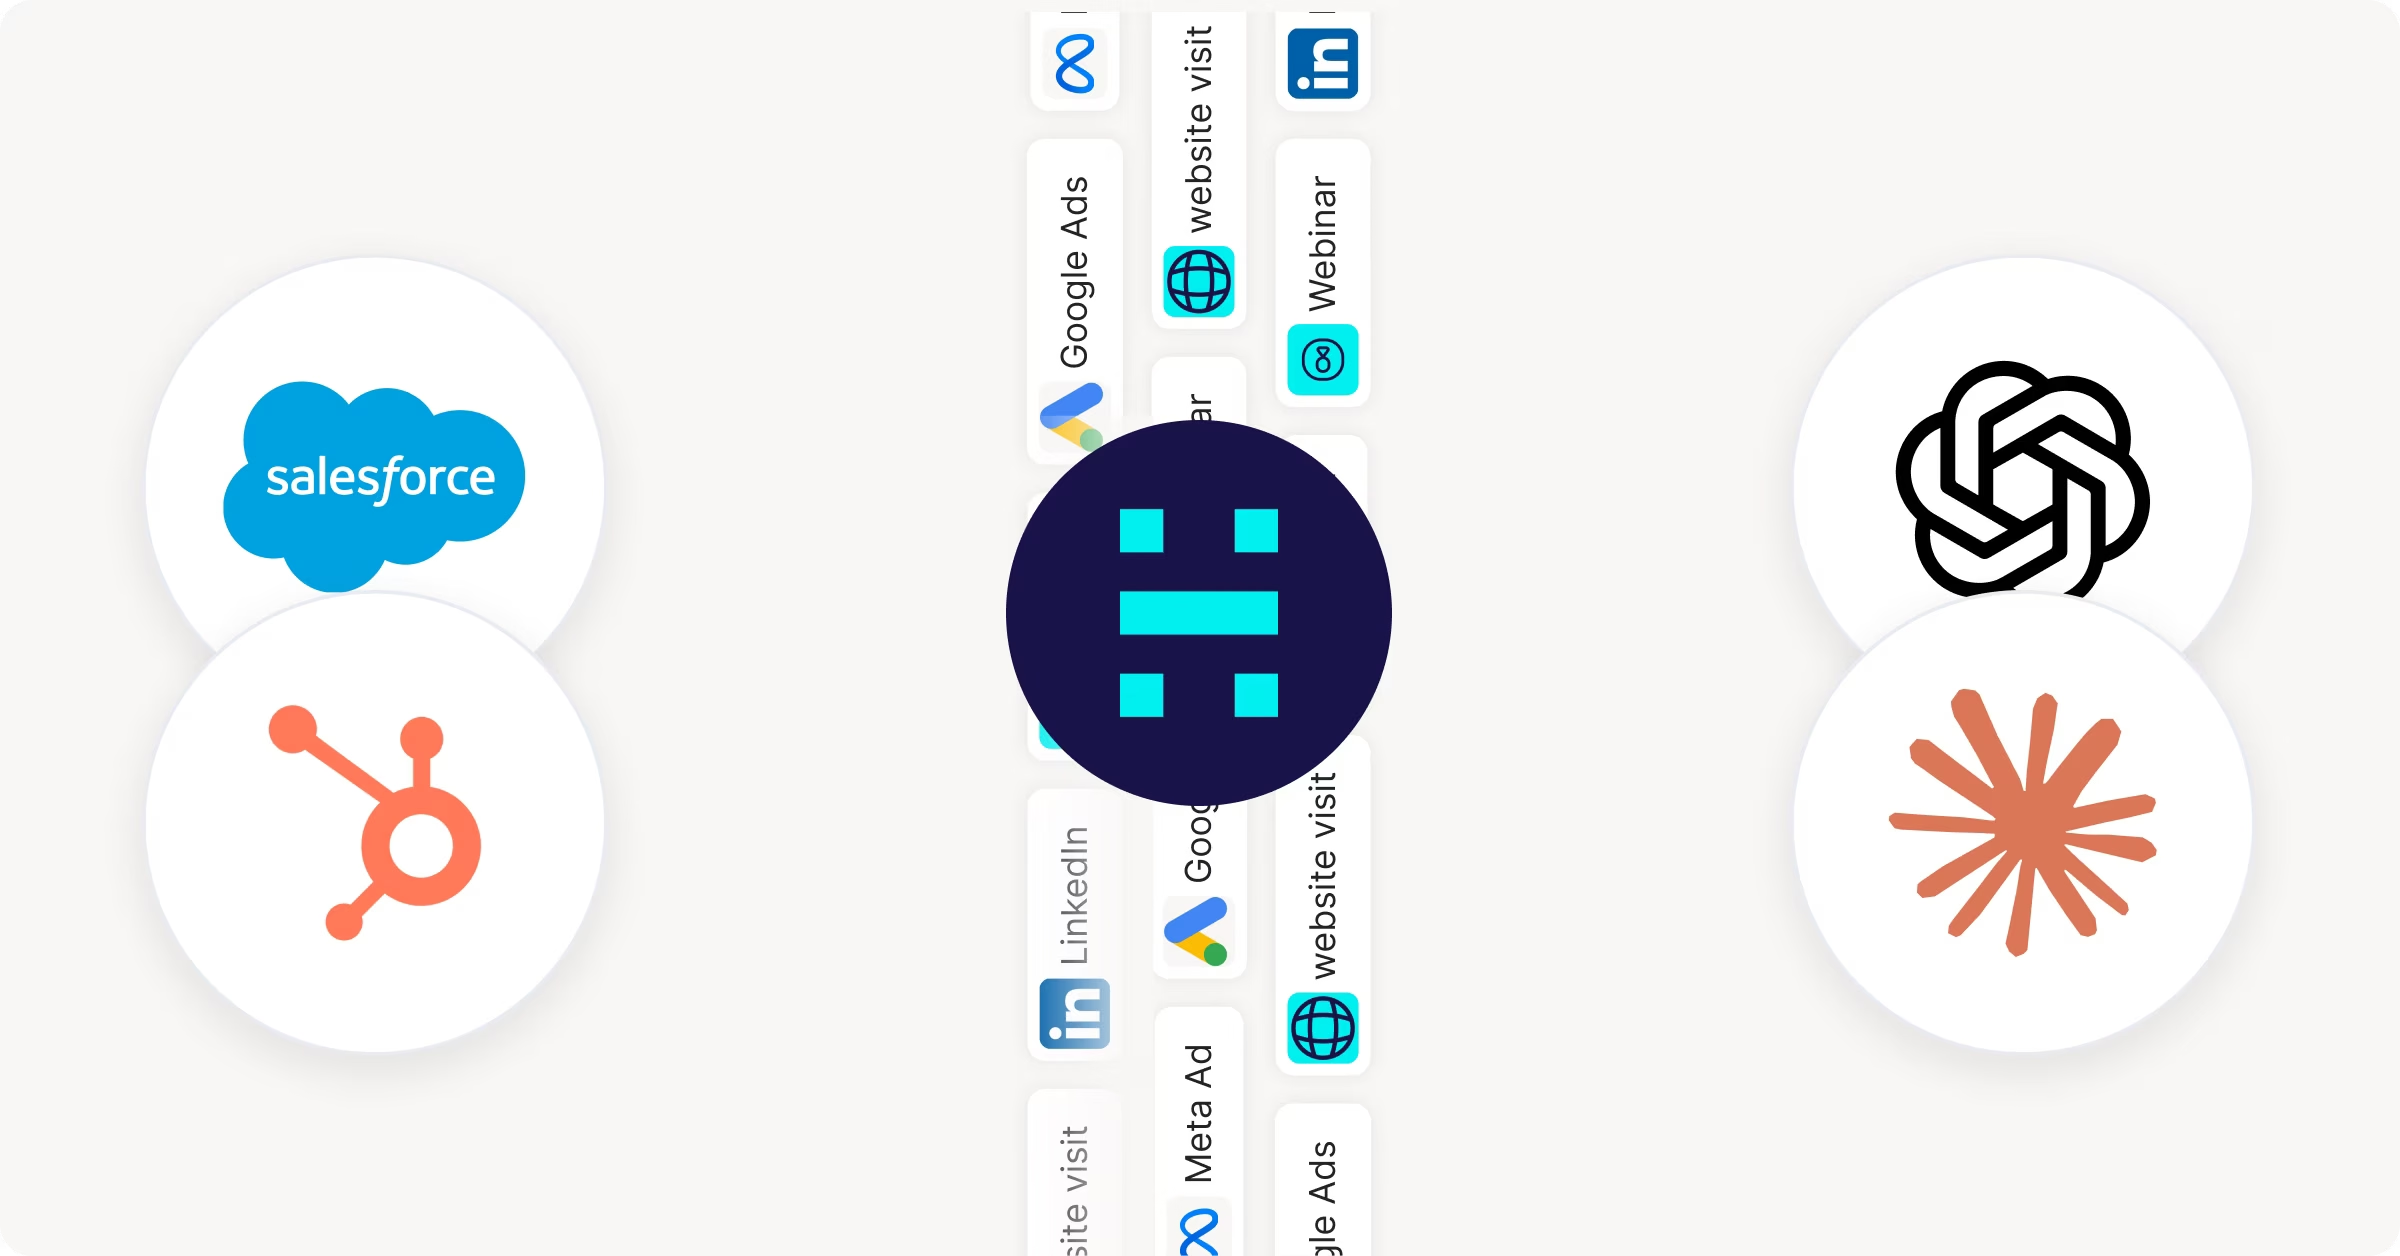
Il s’agit d’abord des interactions avec vos annonces. Google Ads conserve les dépenses publicitaires, LinkedIn stocke l’engagement sur LinkedIn, et vos autres plateformes publicitaires et canaux marketing gardent eux aussi leurs données en silos.
L’engagement sur vos contenus est un autre angle mort que votre CRM, ou votre analyste IA, ne peut pas combler seul. La session anonyme qui précède le remplissage du formulaire n’est enregistrée nulle part.
Avec des trous aussi béants dans les données, toute question sur les campagnes qui ont influencé le pipeline du trimestre dernier devient inutile. Au mieux, l’IA répondra à partir des lignes Campaign Influence disponibles, sans vous dire lesquelles elle n’a pas pu voir. Vous obtiendrez l’une de ces deux réponses : une explication indiquant qu’elle ne peut pas livrer d’analyse fiable faute de contexte, ou une réponse inexacte, présentée avec assurance.
Sans ce contexte, impossible de relier une campagne à un deal signé et à son influence totale sur le revenu, quel que soit le niveau du modèle.
Comme d’autres acteurs de la marketing et revenue intelligence, Heeet s’attache à rassembler le contexte nécessaire pour que votre CRM puisse faire le lien, et que le LLM de votre choix raisonne sur le bon contexte pour répondre, puis agir en conséquence. Notion, de son côté, s’impose peu à peu comme le context layer du savoir de l’entreprise, en fournissant à ses agents le contexte dont ils ont besoin pour agir.
Les équipes marketing, commerciales et revenu ont besoin de suivre ce que le marketing a fait, et de s’assurer que ce contexte est directement relié aux fiches de revenu actuelles ou, mieux encore, qu’il vit au même endroit. Relier la marketing intelligence à votre CRM est avant tout une question de fiches CRM plutôt que d’IA, et aucun prompt ne vous permettra de contourner ce problème.
Une fois les deux reliés, vous pouvez exploiter l’analyse de haut niveau que proposent ChatGPT Astra ou Fable 5.1, puis aller plus loin dans vos prompts pour orchestrer vos agents, directement depuis leurs applications respectives ou leur interface en ligne de commande.
Qu’est-ce qu’un GTM context layer ?
En clair, un GTM context layer est un enregistrement structuré de toutes les interactions marketing d’un prospect avec votre entreprise, saisi dans le CRM à côté du pipeline et du revenu qu’elles ont influencés. Il comprend les clics payants, les lectures de contenus, l’engagement sur LinkedIn, les visites issues de la recherche IA, la participation aux webinaires et les coûts publicitaires, tous rattachés aux fiches Lead, Account et Opportunity que les outils d’IA savent déjà lire.
D’autres sources de contexte peuvent le compléter, comme des outils d’enrichissement tels que Clay. Ensemble, elles donnent aux agents le contexte dont ils ont besoin pour avancer plus vite avec des données exactes. C’est l’avantage concurrentiel que se construisent les équipes dotées d’une solution de marketing intelligence capable de livrer une attribution marketing et revenu, pour simplifier leurs processus.
Nous n’avons pas inventé le concept de context layer. Les entreprises l’emploient de plus en plus pour décrire leur rôle : centraliser des données issues de multiples sources (le « contexte ») et agir dessus grâce à l’IA.
Notion en est devenu un parfait exemple. Lors du lancement de sa Developer Platform le 13 mai 2026, Ivan Zhao a résumé son approche ainsi : « n’importe quelle donnée, n’importe quel outil, n’importe quel agent ». Notion a lancé les Custom Agents en février, et ses clients en ont créé plus d’un million depuis.
Positionné comme la base de connaissances où les collaborateurs travaillent au quotidien, Notion est devenu la couche mémoire, une couche de connaissances et, oui, le context layer des agents personnalisés de la plateforme ou de l’outil d’IA de votre choix. Notion n’emploie lui-même aucun de ces termes. C’est notre lecture de ce qu’ils développent, et une illustration d’un principe simple : un agent ne vaut que par les fiches auxquelles il a accès.
Autre exemple de context layer en construction dans l’univers marketing : le context layer SEO/GEO que bâtissent les équipes d’AirOps et de Profound. En accédant à Google Analytics 4, à Google Search Console et aux données SEO de plusieurs index, principalement celui de Google, en plus de leurs données de visibilité IA, elles centralisent les données nécessaires pour piloter votre stratégie de contenu afin que vous soyez vu et recommandé.
À mesure que les context layers se multiplient dans la stack marketing, un workflow très courant va se dessiner dans les entreprises B2B. Notion contient tout le savoir de l’entreprise (documents, décisions, plans, comptes rendus de réunion). AirOps ou Profound détiennent le contexte de recherche et de contenu. Salesforce ou HubSpot contiennent ce que l’entreprise vend, c’est-à-dire les comptes et les deals, avec le revenu signé. Heeet, comme d’autres outils concurrents, se positionne pour fournir le contexte marketing et GTM qui vit en dehors d’une base de connaissances, du contexte SEO et de votre CRM, afin de compléter le tableau pour vos agents, où que vous les déployiez.
Le GTM context layer occupe précisément ce vide
L’expression « données marketing vérifiées » ne sert à rien si elle n’est pas clairement définie. Ici, elle recouvre trois choses précises : des touchpoints stockés sous forme de fiches CRM, soumis aux règles de permission du CRM ; des coûts publicitaires synchronisés toutes les heures depuis Google, LinkedIn et les autres plateformes, au lieu d’être saisis dans un tableur à la fin de chaque mois ; et chaque crédit rapproché du montant d’un deal closed-won, selon un modèle choisi par votre équipe et qu’elle peut examiner. Une donnée qui ne remplit pas ces trois critères ne mérite pas ce qualificatif.
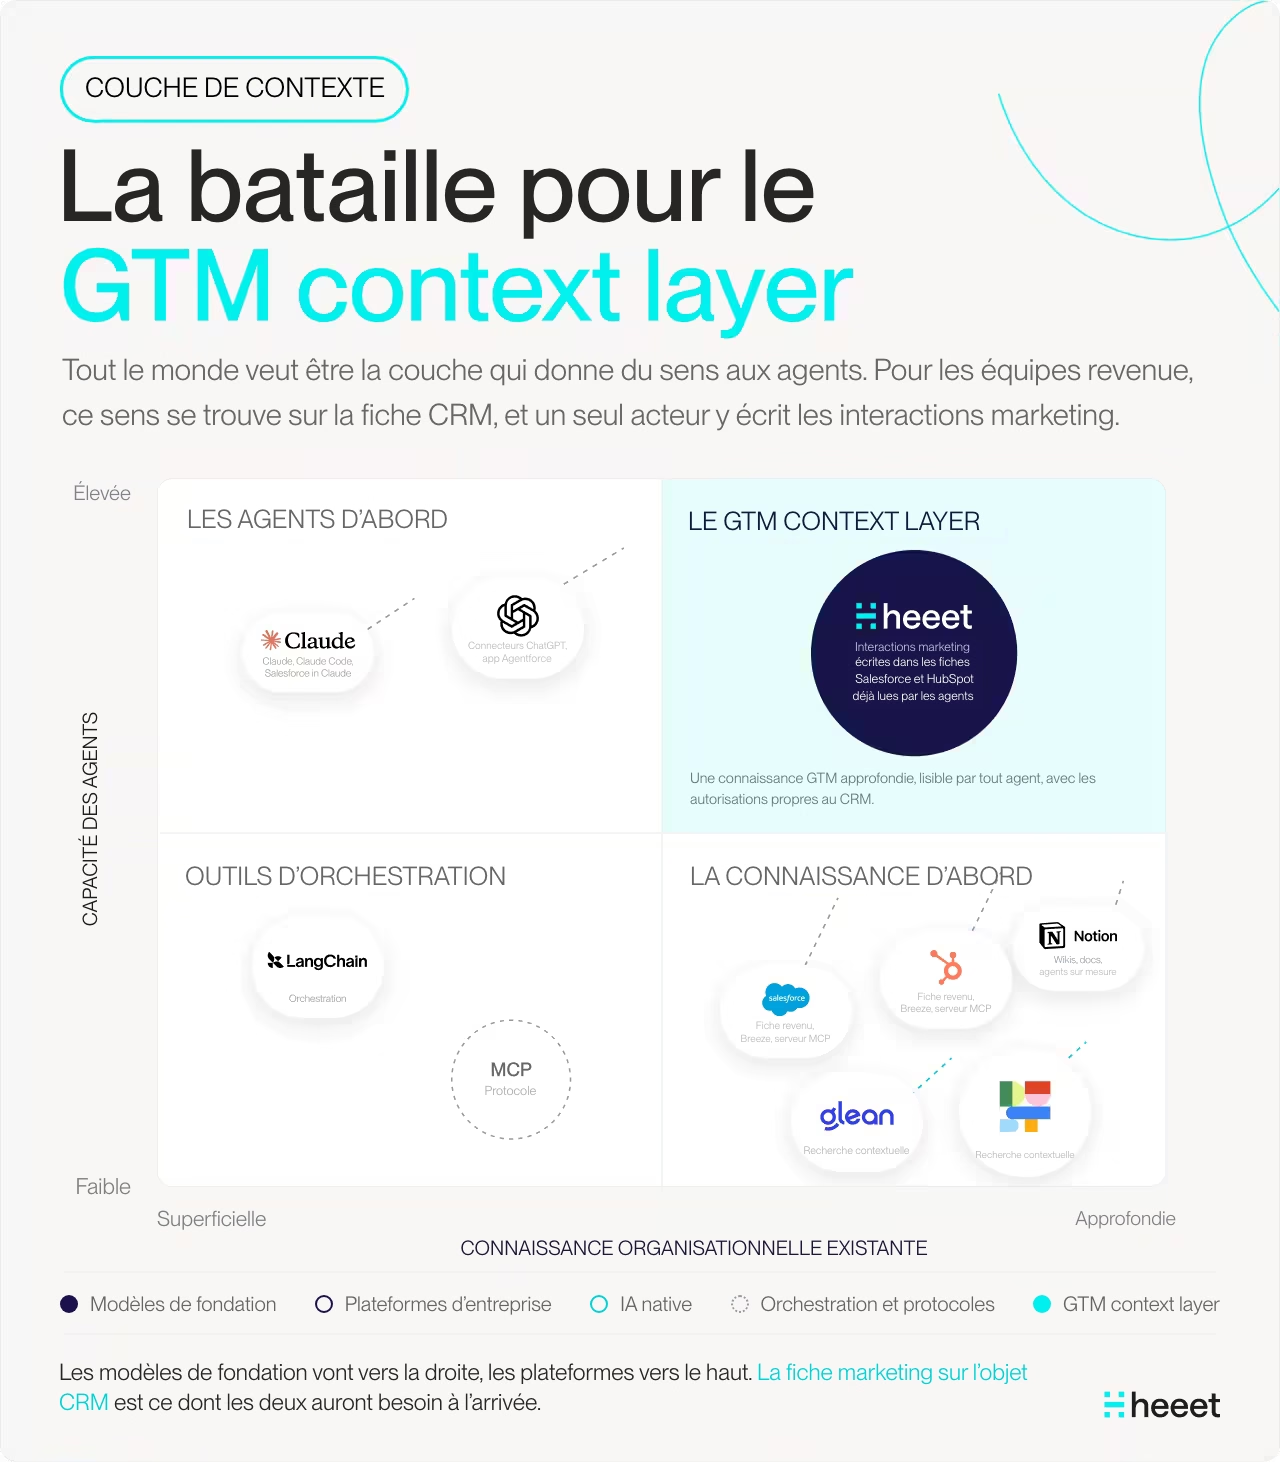
Claude et ChatGPT ne peuvent pas répondre aux questions marketing à partir du seul CRM
L’IA ne peut raisonner qu’à partir des fiches que contient le CRM. Or les CRM ont été conçus pour stocker des informations sur les relations et les deals, pas sur les interactions marketing. Ce contexte leur échappe donc, à moins d’installer une batterie de MCP et de connecteurs. Et même dans ce cas, rien n’est rassemblé en un seul endroit pour créer une source unique de vérité, capable de fournir des données d’attribution et de parcours client exactes, rattachées au pipeline et au revenu de votre CRM.
C’est le GTM context layer qui fait le lien entre tout cela.
Les dépenses publicitaires, les impressions, les sessions web anonymes, l’engagement LinkedIn et le crédit multi-touch sont dispersés dans d’autres outils. Heeet rassemble le tout. C’est ce qui nous permet de répondre aux questions d’attribution avec confiance.
La marketing intelligence repose sur quatre flux de données distincts :
- Les données de dépenses et de performance issues des plateformes publicitaires.
- Les données d’engagement web et contenu, y compris les sessions qui précèdent l’identification des visiteurs.
- Les données de pipeline et de revenu.
- Les données de source déclarée, c’est-à-dire la réponse libre à la question « Comment avez-vous entendu parler de nous ? », qui surpasse généralement les autres modèles d’attribution de la stack.
Les lacunes des intégrations propres au CRM
Salesforce et HubSpot ont aussi leurs faiblesses en matière de saisie et d’accès aux données. Votre CRM détient bien les données de pipeline et de revenu, mais certaines limites liées à l’IA sont propres aux CRM et peuvent fournir un mauvais contexte à votre outil d’IA :
- Le connecteur HubSpot pour Claude ne peut pas lire les objets personnalisés, une lacune importante pour les équipes.
- L’IA ne peut pas compenser les Contact Roles et les Campaign Members manquants dans Salesforce. C’est également vrai pour les données manquantes dans HubSpot.
La fiabilité de Salesforce Campaign Influence dépend des Contact Roles. Dans les organisations que nous découvrons lors de l’onboarding, leur taux de complétion varie de 30 à 50 %, ce qui limite ce que peut montrer tout modèle multi-touch qui s’appuie dessus.
Dans un dashboard, le manque saute aux yeux. Une réponse dans un chat, elle, le dissimule.
Si un rapport indique que 4 % du pipeline provient du marketing, le CMO remarquera l’écart et cherchera à l’expliquer. Mais si Claude produit un paragraphe d’analyse assurée sur trois campagnes, ces trous vous laissent avec un reporting erroné.
Nos nouveaux prospects nous répètent sans cesse que leur outil d’attribution a lâché pour la même raison : les commerciaux n’associent pas les Contacts aux Opportunities.
Chiffrons-le. Une équipe qui dépense 42 000 $ par mois sur Google Ads demande à Claude le retour par canal. Le CRM ne contient aucun champ de coût pour ces campagnes. Le modèle fait donc ce que ferait n’importe quel analyste avec les mêmes données : il répond à la question à laquelle il peut répondre, sur le nombre de deals et la progression entre les étapes, et les 42 000 $ n’entrent jamais dans le calcul.
Qu’est-ce que Heeet écrit dans Salesforce et HubSpot ?
Heeet inscrit le first-click, le last-click et chaque touchpoint intermédiaire sur les fiches Lead, Account et Opportunity. Il crée et met à jour toutes les heures les campagnes payantes, avec leur coût, leurs impressions et leurs clics. Il enregistre les lectures de contenus et l’engagement LinkedIn des Contacts connus, et attribue le crédit de revenu à chaque touchpoint selon le modèle que vous configurez. Le tout sous forme de fiches CRM natives.
Dans le détail, car c’est ce qui détermine si un outil d’IA a de quoi travailler :
- Les clics payants issus de Google, LinkedIn, Bing, Meta et Reddit, avec la campagne créée automatiquement dans le CRM et son coût rattaché.
- Les visites organiques et issues de la recherche IA, classées par moteur : une session démarrée dans ChatGPT, Perplexity, Gemini ou Claude arrive étiquetée, au lieu d’être comptée en trafic direct.
- Les pages vues et les actions sur les pages, y compris les téléchargements en accès libre, sans formulaire.
- L’engagement LinkedIn organique des Contacts déjà présents dans le CRM.
- La participation aux webinaires et aux événements, enregistrée comme une influence post-acquisition et non comme une nouvelle source de lead.
- La source déclarée, conservée comme une ligne d’influence à part entière au lieu d’être écrasée par le dernier clic.
- L’activité commerciale, placée à côté de l’activité marketing pour que le nombre de touchpoints reflète l’ensemble de la relation.
Heeet répond aussi au problème des Contact Roles. Heeet calcule l’influence au niveau de l’Account, dans la fenêtre de l’Opportunity. Un touchpoint marketing sur n’importe quel Contact de cet Account compte pour le deal, que le commercial ait pensé ou non à ajouter la personne comme Contact Role.
Comment poser une question d’attribution marketing à Claude dans Salesforce ?
Connectez Salesforce à Claude grâce au plugin Salesforce in Claude (en bêta ouverte depuis septembre 2026) ou au serveur MCP Salesforce dans Claude Code. Vérifiez les objets auxquels votre utilisateur a accès. Posez ensuite votre question en langage courant. La réponse ne sera jamais plus complète que les fiches de campagne, de coût et de touchpoint présentes dans ces objets.
Un peu de contexte sur ce qui a été lancé
Salesforce et Anthropic ont annoncé leur partenariat le 26 août 2026. Salesforce in Claude arrive avec 37 skills prêtes à l’emploi pour préparer les réunions, évaluer la santé des deals et passer en revue le pipeline. Elles reposent sur AIforce, que Salesforce présente comme le « harness » qui expose ses données et ses workflows grâce à des serveurs MCP, des API et des outils CLI. Les permissions sont gérées de façon centralisée. Claude Code figure parmi les composants. Dario Amodei a résumé l’enjeu : apporter l’intelligence « dans les systèmes où se déroule une grande partie de l’activité commerciale mondiale ».
Parcourez la liste des 37 skills et voyez ce qui manque : aucune ne porte sur la performance marketing. Le marketing obtient l’interface, mais ni les skills ni les données.
Voici comment procéder, en supposant que votre administrateur a activé le plugin :
- Connectez le plugin → votre administrateur Salesforce active Salesforce in Claude, ou vous ajoutez vous-même le serveur MCP Salesforce à Claude Code.
- Résultat attendu : Claude renvoie la liste des objets qu’il peut lire.
- Piège à éviter : il hérite exactement de vos permissions Salesforce. Un marketeur sans droit de lecture sur les Opportunities n’obtient rien sur le revenu, et le modèle ne dira pas pourquoi.
Vérifiez aussi l’exactitude des données avant de poser une vraie question :
- Demandez-lui de lister les champs auxquels il a accès sur Campaign, CampaignMember, CampaignInfluence et Opportunity, et de préciser ceux qui sont réellement renseignés, pas seulement présents.
- Résultat attendu sans context layer : coût de Campaign vide, aucune fiche web, aucune fiche publicitaire.
- Avec Heeet en place : fiches d’influence, coût de campagne, impressions et clics, tous renseignés.
Commencez par une question simple sur le revenu, par exemple : « Quelles campagnes ont influencé le plus d’Opportunities au Q3, avec leur coût et leur crédit de revenu ? » Observez le résultat et vérifiez s’il est exact.
Passez ensuite aux questions que posera votre CFO :
- le coût par Opportunity influencée dans le pipeline, ventilé par canal.
Une fois les dépenses inscrites sur la fiche CRM, le modèle peut commencer à raisonner et vous donner les réponses.
Enregistrez les prompts qui ont fonctionné sous forme de skill ou de requête sauvegardée : l’équipe arrêtera de reconstruire la même question chaque trimestre et d’obtenir des réponses légèrement différentes à chaque fois.
Nous connectons Claude à notre propre org de démo ce mois-ci pour produire les captures d’écran du tutoriel. Côté calendrier, soyons honnêtes : le plugin est en bêta ouverte et la couverture des objets évolue. Vérifiez-la le jour de votre configuration plutôt que de vous fier à une liste publiée en septembre.
Et HubSpot ? Le même context layer, un autre modèle de données
Le serveur MCP distant de HubSpot est passé en disponibilité générale le 13 avril 2026, et ses connecteurs transmettent le contexte HubSpot à Claude, ChatGPT, Gemini et Copilot. Le connecteur lit les contacts, les companies, les deals et les engagements. Il ne peut pas lire les objets personnalisés. Il ne voit jamais non plus les dépenses publicitaires ni les sessions anonymes. Heeet écrit donc ces données dans les objets standard auxquels le connecteur a accès.
La formule de HubSpot sur le sujet est bien trouvée : « L’IA ne connaît pas votre entreprise. Avec HubSpot, désormais, elle le peut. » J’y souscris. Reste à savoir ce que « votre entreprise » englobe par défaut.
Trois éléments en sont exclus. L’attribution du revenu et les modèles multi-touch sont réservés à Marketing Hub Enterprise, affiché à 3 600 $ par mois. Ces modèles ne créditent que les interactions suivies par HubSpot et laissent de côté tout ce qui s’est passé sur une plateforme qui n’appartient pas à HubSpot. Enfin, les dépenses publicitaires, bien qu’elles se trouvent dans l’outil Ads de HubSpot lui-même, n’atteignent jamais les rapports d’attribution.
Voici comment fonctionne notre intégration HubSpot : elle écrit les touchpoints et les coûts sur les Deals, les Contacts et les propriétés standard que le connecteur peut lire, et conserve le modèle d’attribution de notre côté, car les modèles proposés par HubSpot ne permettent pas d’en configurer un comme la plupart des équipes en ont besoin. Le sujet est revenu lors d’une démo avec Rocketlane en août 2026. Il revient presque chaque semaine.
Une précision : ce qui suit est une anticipation, rien n’est encore livré. HubSpot a lancé Run Agent comme étape de workflow en juillet 2026, et une Agent CLI en juin. Nous nous attendons à ce que le connecteur en lecture seule et les agents de workflow convergent. Ce jour-là, ces agents agiront sur la fiche marketing présente sur l’objet. Mieux vaut donc l’écrire dès maintenant que plus tard.
Quelle est la suite ?
Aujourd’hui, le GTM context layer répond à des questions. Bientôt, il fournira des idées de campagnes, des ciblages et des assets à un outil qui les exécutera grâce à des connecteurs MCP vers les plateformes publicitaires, puis renverra le tout dans le CRM. Les marketeurs consacreront alors leur temps à décider quoi lancer plutôt qu’à le paramétrer.
Nous travaillons à faire de ce scénario une réalité. Certaines briques existent déjà :
- Les déclencheurs de conversions offline renvoient le revenu closed-won vers Google Ads et GA4.
- L’activation d’audiences envoie des segments CRM vers les plateformes.
- L’analyse des parcours fait ressortir les chemins qui convertissent le plus vite.
- La performance des contenus par persona alimente déjà le ciblage LinkedIn dans les démos que nous menons aujourd’hui.
Imaginez maintenant la version qui n’existe pas encore. Claude lit les données de parcours de vos Opportunities, vous indique les trois parcours à prioriser ce trimestre, rédige la campagne LinkedIn destinée au persona qui convertit sur ce contenu et pousse une audience d’exclusion vers Google Ads. Vous arrêtez ainsi de payer pour toucher des personnes déjà engagées dans un cycle de vente. Vous validez, ou non, avec un humain dans la boucle. Ne l’oubliez pas.
Rien dans ce scénario n’exige une nouvelle interface. Tout repose sur la fiche présente sur l’objet, et sur quelqu’un qui pose les bonnes questions à l’IA.
Êtes-vous prêt à suivre les prospects du lead à la clôture avec Heeet ?
Heet permet aux spécialistes du marketing et des ventes des entreprises informatiques et de sécurité de transformer leurs conjections en décisions éclairées qui génèrent des revenus tout en respectant les mêmes normes techniques de sécurité que celles que vous offrez à vos clients.